Ein Bezug,
den man sehen kann.
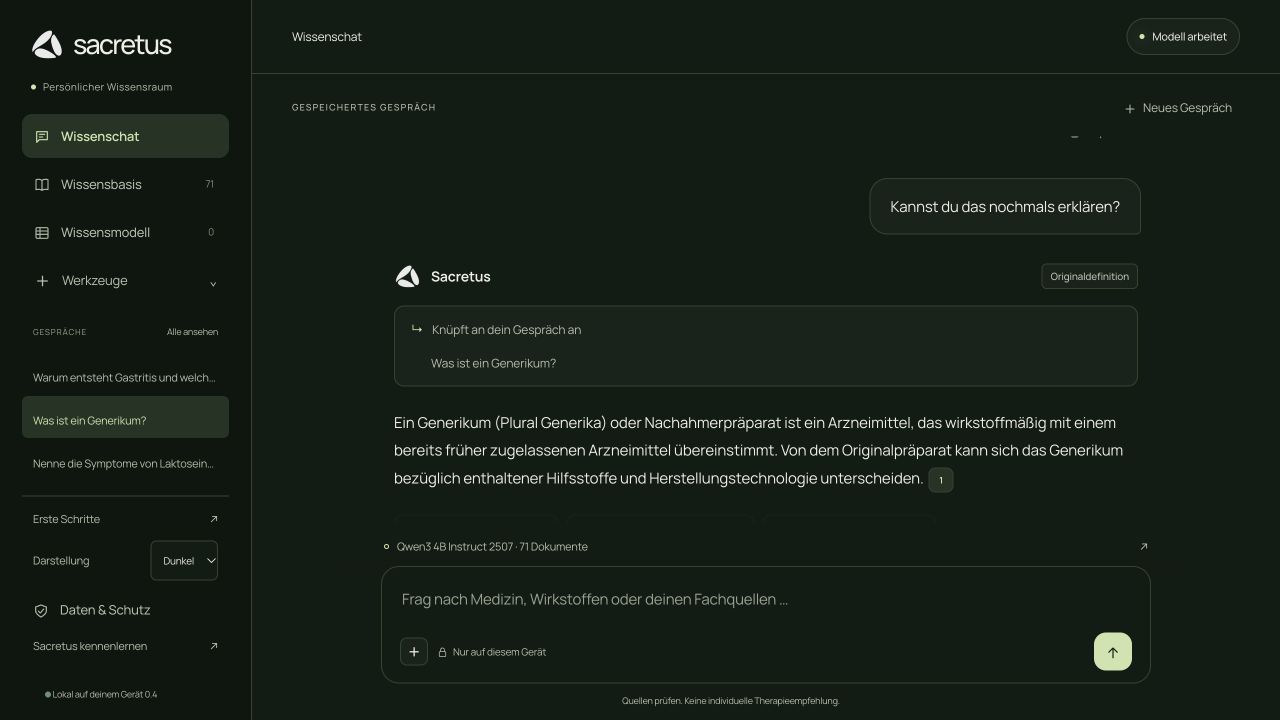
Bei einem erkannten Gesprächsbezug zeigt die App die referenzierte Frage. Mehrdeutige Bezüge können eine Rückfrage erfordern.
 sacretus.Pilot-Login ↗
So sieht die Arbeit mit Sacretus aus. Echte Ansichten aus einer isolierten Testumgebung auf unserem VPS. Öffentliche Fachtexte, ein kleines lokales Sprachmodell und die Sacretus-Engine.
Die Anwendung ansehen ↓Früherer Dialogstand vom 16. Oktober 2026, vor der aktuellen Quellenerweiterung. Neue Messungen und Fälle stehen im Prüfstand. Die Beispiele zeigen ausgewählte Funktionen und Grenzen. Sie sind kein Nachweis klinischer Richtigkeit oder allgemeiner Fehlerfreiheit.
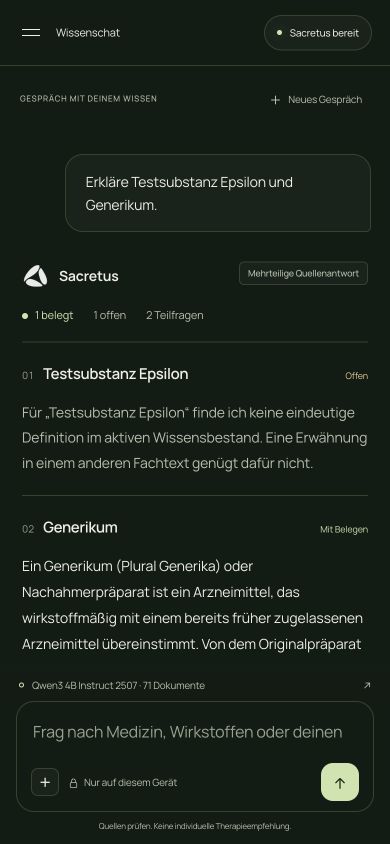
Das Sprachmodell zerlegt die Frage in begrenzte Aufträge. Sacretus bearbeitet die Teile einzeln und zeigt die gefundenen Quellen sowie offene Punkte.
Bei einem erkannten Gesprächsbezug zeigt die App die referenzierte Frage. Mehrdeutige Bezüge können eine Rückfrage erfordern.
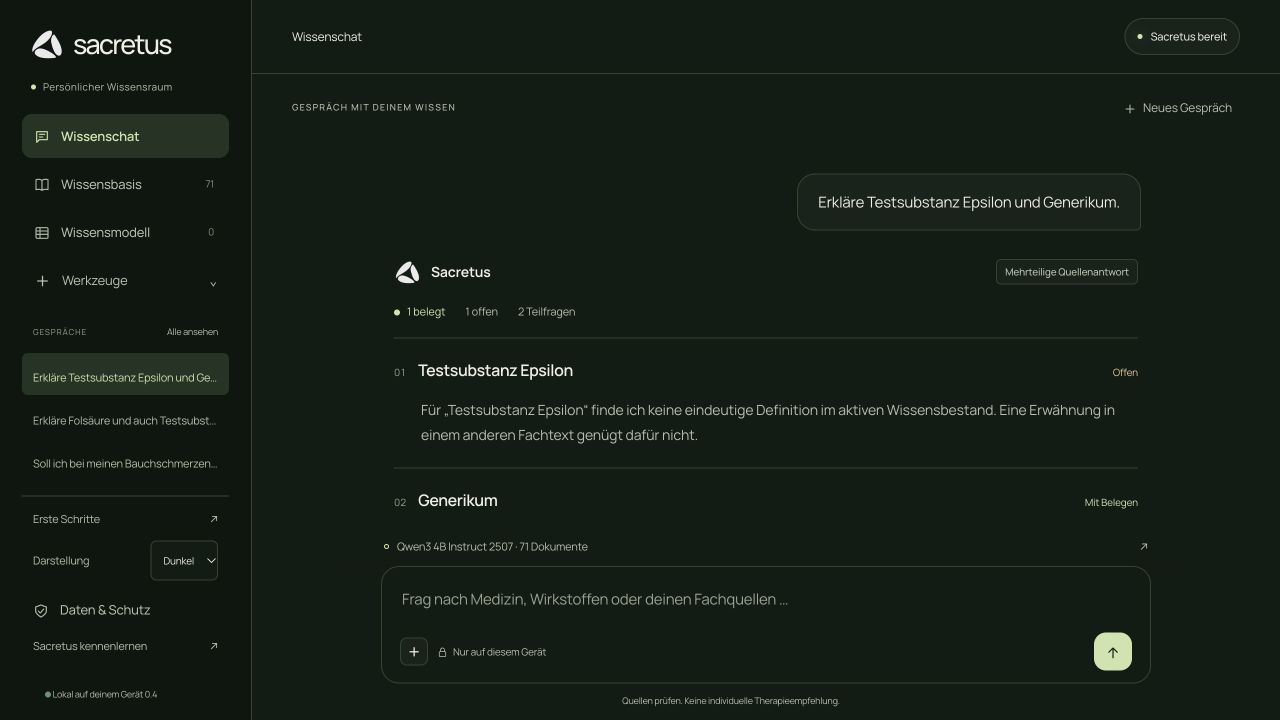
In diesem Beispiel bleibt der unbekannte Gegenstand ausdrücklich offen. Der belegte Teil wird daneben beantwortet.
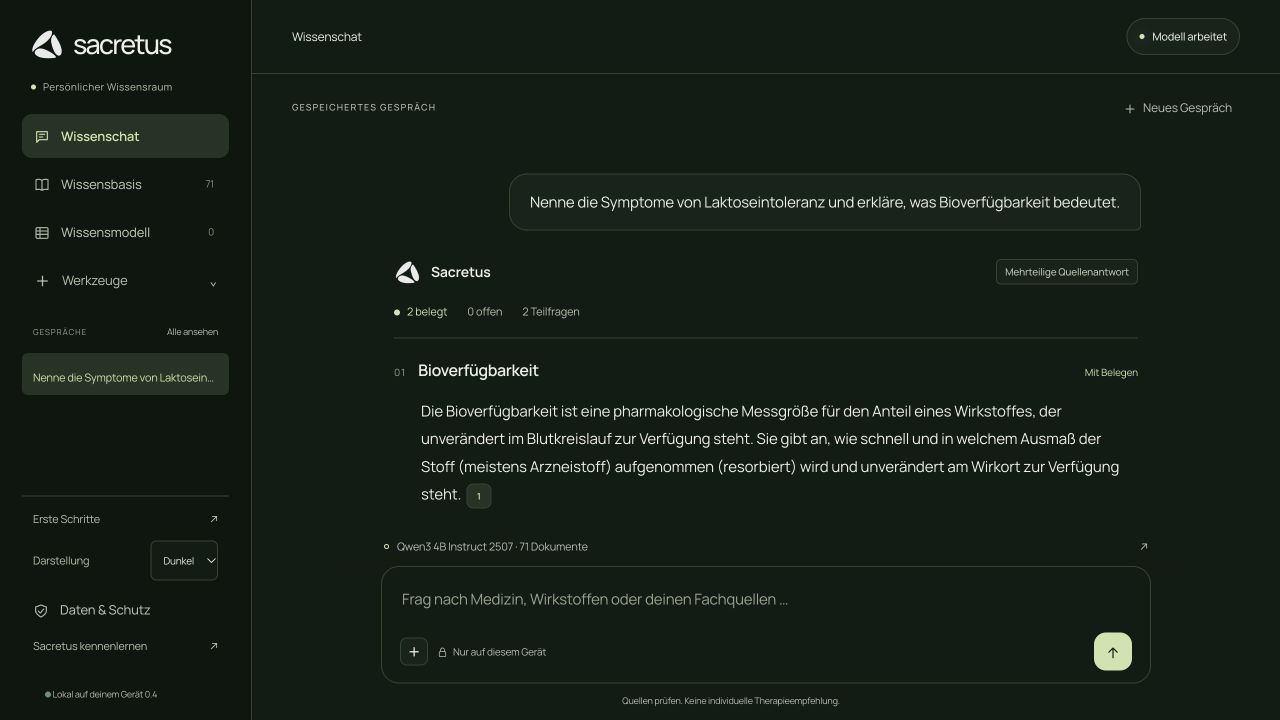
Quellenverweise öffnen die verwendete Fundstelle. Der Antwortnachweis hält die Zuordnung zur gespeicherten Version fest.
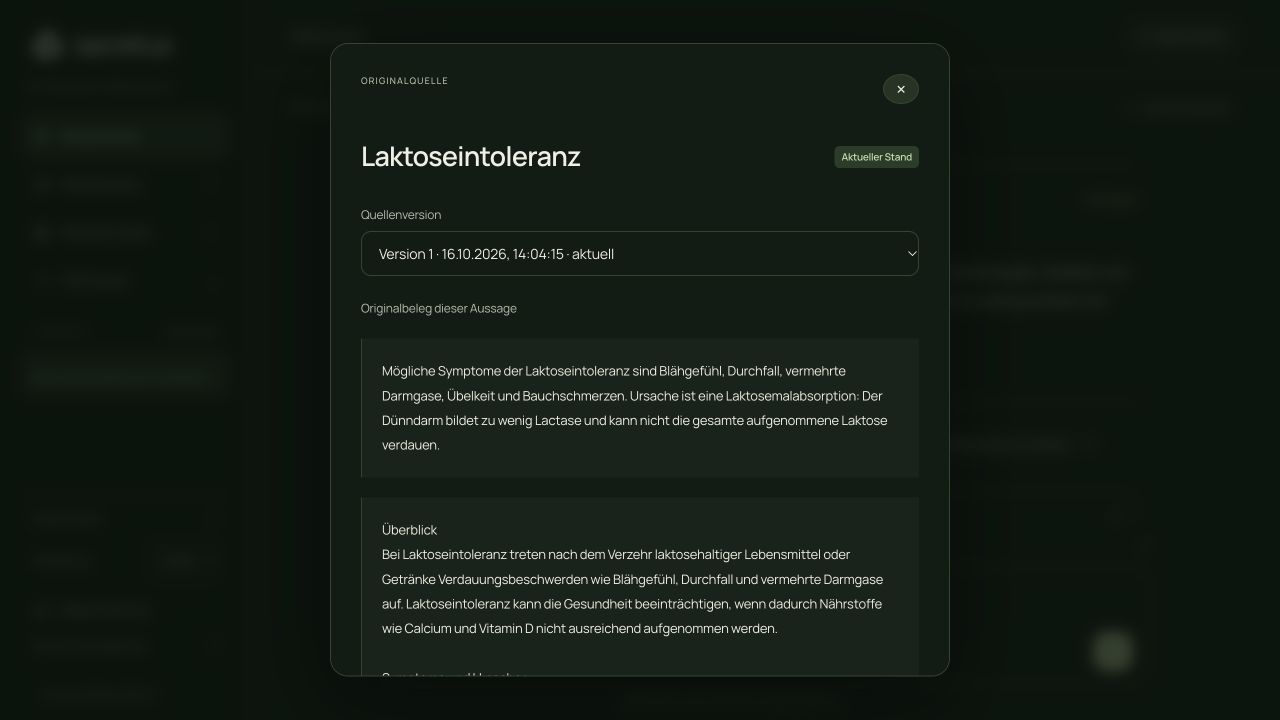
Modell, Quantisierung, Bestandsgröße und verwendeter Gesprächskontext lassen sich im Wissensraum einsehen.
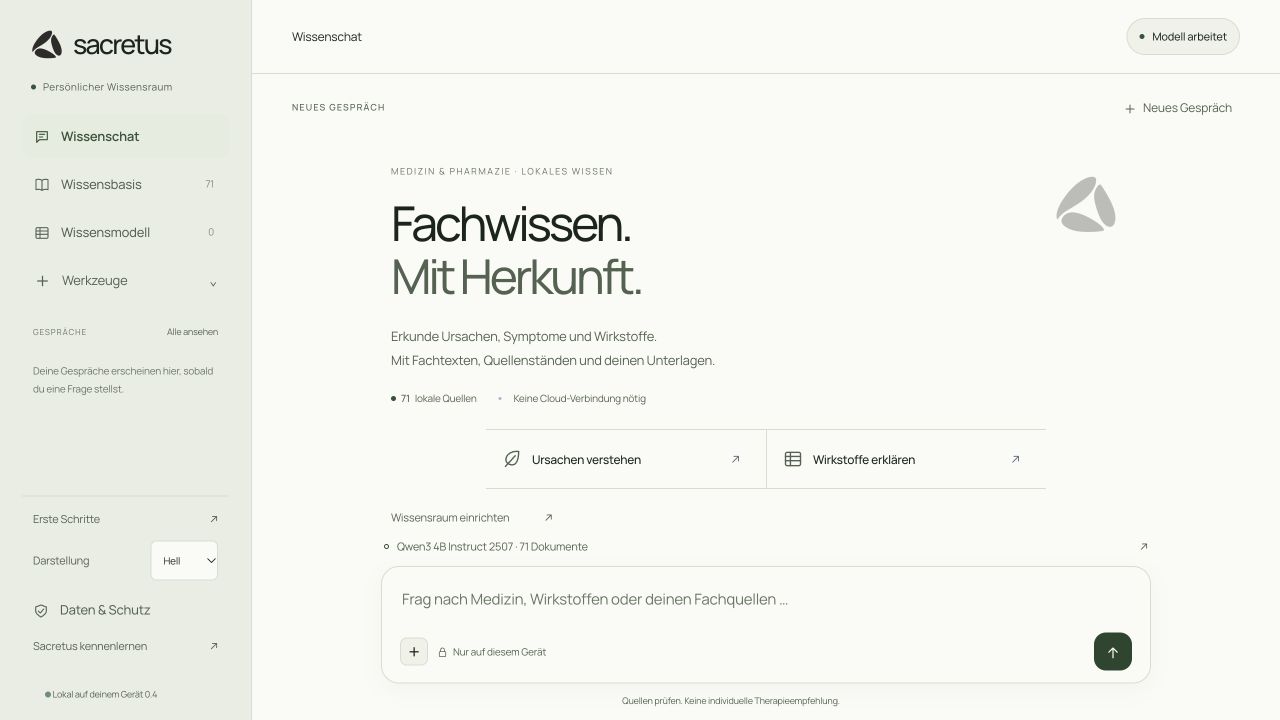
Helle und dunkle Darstellung, klare Typografie und dezente Bewegungen. Bei reduzierter Bewegung bleibt die Oberfläche ruhig.
Die Navigation weicht auf kleinen Bildschirmen zurück. Fragen, Belege und offene Punkte bleiben lesbar.
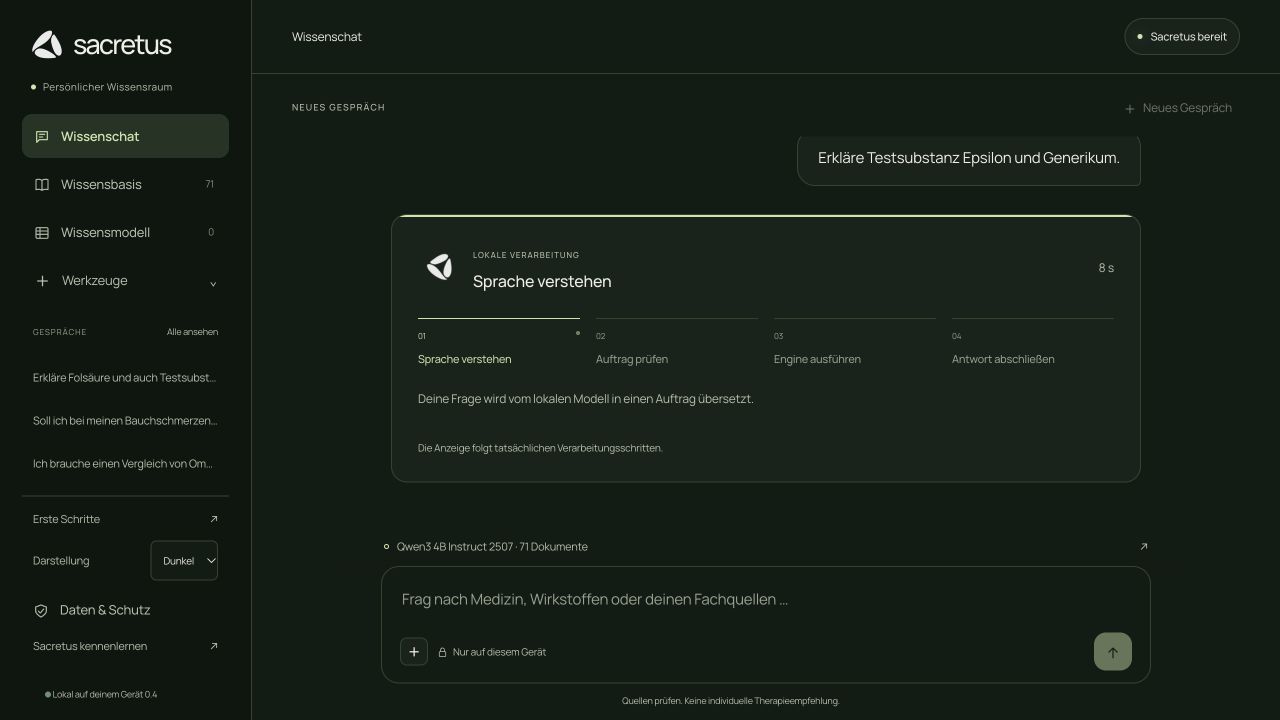
Die Anzeige folgt den Ereignissen der Anwendung: Sprache verstehen, Auftrag prüfen, Engine ausführen und Antwort abschließen. Sie zeigt keinen erfundenen Gedankengang und keine simulierten Fortschrittsprozente.
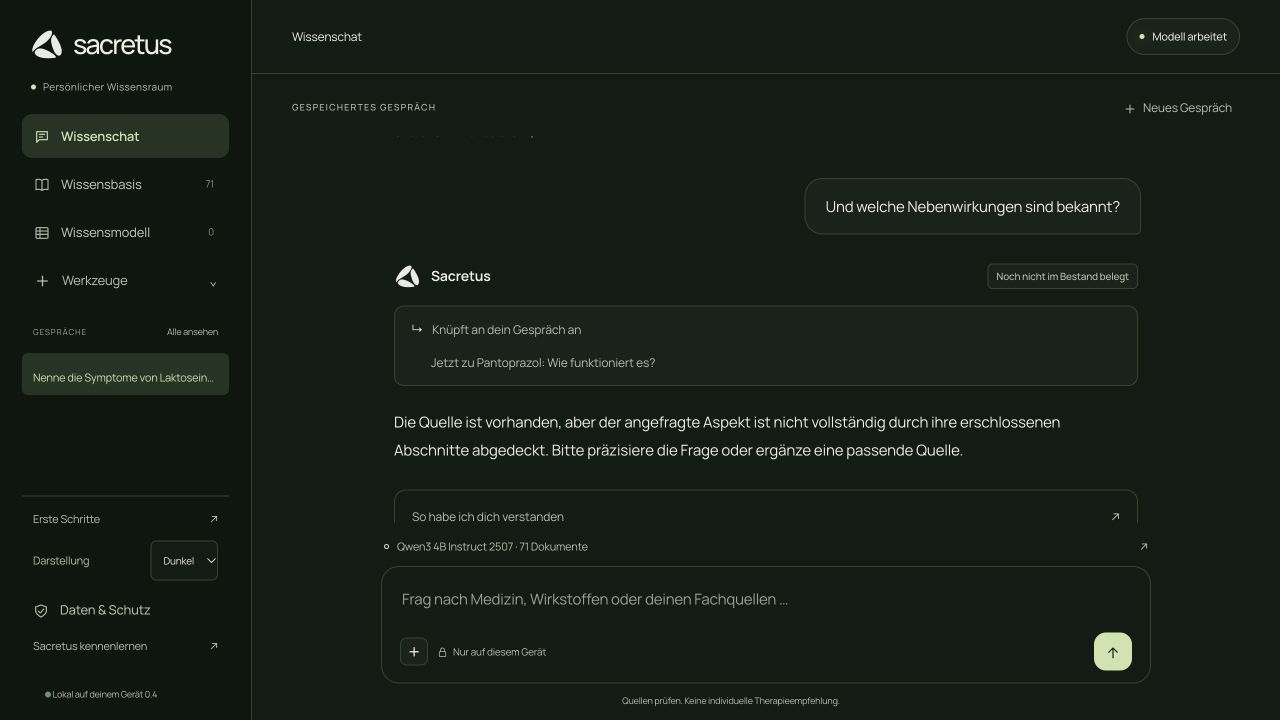
Die Anschlussfrage zu Nebenwirkungen bezieht sich korrekt auf Pantoprazol. Dieser frühere Testbestand enthielt dazu keinen ausreichend erschlossenen Abschnitt. Sacretus zeigt diese Lücke. Sprachverständnis und fachliche Abdeckung sind zwei getrennte Anforderungen.
Das lokale Modell interpretiert Absicht, Teilfragen und Gesprächsbezüge. Es erhält die Frage und begrenzte frühere Aufträge, keine Fachtexte. Der Kern prüft Struktur, Namensherkunft und Referenzen. Er deutet die Frage nicht durch eine Liste fest codierter Frageformulierungen um.
Bis zu vier Aufträge und acht Teilabfragen. Unbenannte Bezüge gelten nur für den letzten Wissensauftrag. Ältere Themen aus höchstens drei vorherigen Aufträgen sind nur mit ausdrücklich genanntem Namen erreichbar. Ungeklärte oder persönliche medizinische Fragen unterbrechen den älteren Themenbezug; Begrüßungen und Dank können ihn erhalten. Enthält der referenzierte Auftrag mehrere Gegenstände, verlangt der Kern ausdrücklich benannte Ziele statt einer unbenannten Auswahl. Erkannte Bedingungen bleiben erhalten; nicht unterstützte Bedingungen führen zu einer Rückfrage. Fachliche Antworten stammen aus gespeicherten Belegen oder freigegebenen Fakten.
Das Modell kann trotzdem falsch verstehen oder einen Aspekt auslassen. Eine passende Quelle kann unvollständig oder veraltet sein. Die Anzeige „belegt“ bezeichnet Quellenzuordnung, nicht medizinische Freigabe. Persönliche Diagnose- und Therapieentscheidungen liegen außerhalb dieses Piloten.
Sprachmodell: Qwen3 4B Instruct 2507 · Q4_K_M. Getestet auf einem VPS mit 4 vCPU und 8 GB RAM; der Testprozess war auf drei CPU-Kerne begrenzt.
Beim damaligen Dialogausbau: 286 Softwareprüfungen bestanden. Geprüft wurden unter anderem Gesprächsbezüge, Zugriffsrechte und Quellenstände. Diese Prüfungen ersetzen keinen echten Modelllauf.
Strikte Sprachzuordnung erfüllt
Median 28,35 s · längste Antwort 43,64 s
Strikte Sprachzuordnung erfüllt
Median 41,17 s · längste Antwort 48,11 s
Diese Zahlen bewerten die Zuordnung der Frage zu einem Auftrag. Sie sind keine Quote medizinisch richtiger Antworten. Die Rohberichte zeigen alle Fälle, einschließlich Rückfragen, Wissenslücken und Fehlzuordnungen. Die Kontextregression enthält drei Prüfungen mehrdeutiger Gesprächsbezüge.
Diese 28 Schritte prüfen die finale Begrenzung unbenannter Bezüge auf das letzte Thema. Sie wiederholen bekannte Fälle nach einem Fehler im vorausgehenden Lauf mit 43 Schritten. Die acht Zusatzfälle waren vor diesem vorausgehenden Lauf festgelegt worden und sind jetzt ebenfalls Regressionen. Eine unabhängige fachliche und klinische Validierung steht aus. Die Modellmessungen liefen ohne parallelen Software-Testlauf, während die produktiven Dienste erreichbar blieben.