Aufsummierte Dauer der dokumentierten Modellanfragen. Ohne Laden des Modells, Entwicklungszeit oder abgebrochene Läufe.
SACRETUS / ENGINEERING FIELD NOTESVertrauen entsteht
Vertrauen entsteht
im Prüfstand.
Fragen stellen. Quellen prüfen. Grenzen erkennen. Hier dokumentieren wir, wie sich unser lokaler Wissenspilot entwickelt – mit Messungen, nachvollziehbaren Fällen und echten Ansichten aus der Anwendung.
In 27 abgeschlossenen Läufen, einschließlich Wiederholungen und Fehlerfällen. 116 unterschiedliche Fragetexte.
Im letzten abgeschlossenen vollständigen Testlauf bestanden. Prüfen unter anderem Quellen, Rechte, Gesprächsbezüge und Datenimporte.
Die Zahlen beschreiben unterschiedliche Prüfarten und werden nicht zu einer Genauigkeitsquote vermischt. Historische Modellläufe betreffen verschiedene Entwicklungsstände. Alle einbezogenen Berichte und die Zählmethode sind unten verlinkt.
Derselbe Auftrag.
Ein begrenzter Zeitgewinn.
Das Sprachmodell übergibt weiterhin den ausführlichen, benannten Auftrag. Die Engine prüft Gegenstände, Gesprächsbezüge und Einschränkungen wie zuvor. Die Optimierung setzt bei der Berechnung durch das lokale Modell an.
Wiederholte Zeichenfolgen können als kurze Entwürfe gebündelt vorbereitet werden. Das gleiche Sprachmodell prüft diese Entwürfe, bevor sie übernommen werden. Dafür wird kein zusätzliches Modell geladen. Der getestete Ansatz heißt n-gram speculative decoding ↗.
Das lokale Qwen3-Modell bleibt für das Sprachverständnis zuständig. Die fachlichen Inhalte kommen weiterhin aus dem gespeicherten Wissensbestand. Es gibt keine Laufzeitliste fest programmierter Beispielfragen.
DIESELBEN PRÜFFRAGEN · MEDIAN
Vorher
36,71 s
Optimiert
34,45 s
6,2 % kürzere mediane Antwortzeit in diesem Vergleich. 20 identische, vorab festgelegte Testschritte; gleicher Quellenbestand, gleiches Modell, gleicher VPS. Die Läufe erfolgten nacheinander; VPS-Last und Messreihenfolge können das Ergebnis beeinflussen.
Arithmetischer Mittelwert: 41,26 → 33,51 Sekunden. Längste gemessene Antwort: 90,17 → 69,75 Sekunden. Der frühere Lauf enthält einen Timeout; das beeinflusst Mittelwert und Maximum.
Ausgabeformat, Modellanweisungen und Beispiele sind unverändert. Alle Fälle wurden während der Entwicklung bereits betrachtet; der abschließende Lauf ist eine Regression, kein unabhängiger Holdout.
Strikte Auftragszuordnung: vorher 18/20, optimiert 19/20. Das ist keine Quote medizinisch korrekter Antworten und kein zugesichertes Leistungsniveau.
Unser Ziel deutlich schnellerer Antworten ist damit noch nicht erreicht. In der Kontextprüfung betrug der Median 40,05 Sekunden. Die Laufzeiten bleiben je nach Frage und VPS-Last unterschiedlich.
Vergleich und Grenzen lesen ↗Ein Fall wird erst nützlich,
wenn man ihn nachvollziehen kann.
Ausgewählte Fallstudien aus dem dokumentierten Vergleichslauf mit ausführlichem Auftragsformat. Keine Kundenreferenzen und keine Tests an Patientinnen oder Patienten. Sämtliche Ergebnisse des jeweiligen Laufs bleiben im Rohbericht sichtbar.
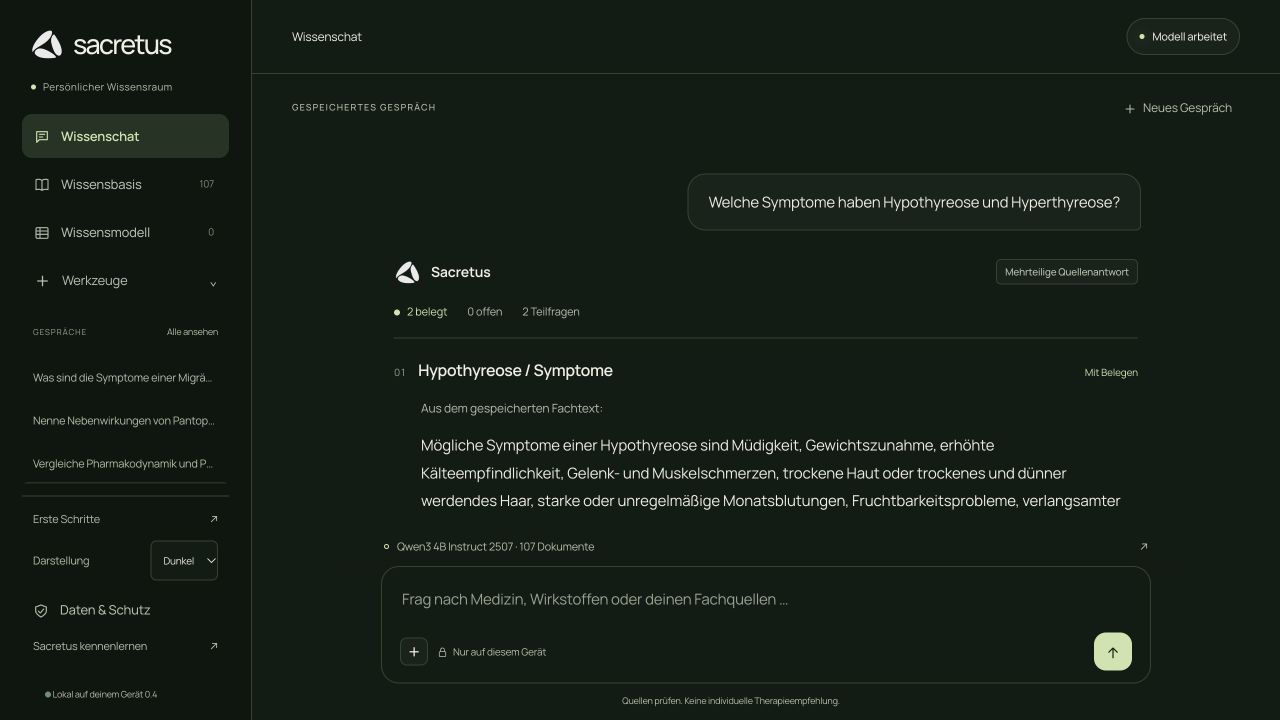
FALL 01 / MEHRTEILIGE FRAGE
Zwei Themen. Zwei belegte Teilantworten.
„Welche Symptome haben Hypothyreose und Hyperthyreose?“
BeobachtungDer Sprachauftrag trennt die beiden Erkrankungen und ordnet beiden die Eigenschaft Symptome zu. Die Engine liefert zwei getrennte Auszüge aus dem lokalen Bestand.
EinordnungDie Aufnahme zeigt einen sichtbaren Ausschnitt des Gesprächs. Die deutschen NIDDK-Bearbeitungen sind noch nicht unabhängig fachlich geprüft.
Vollständigen Testlauf lesen ↗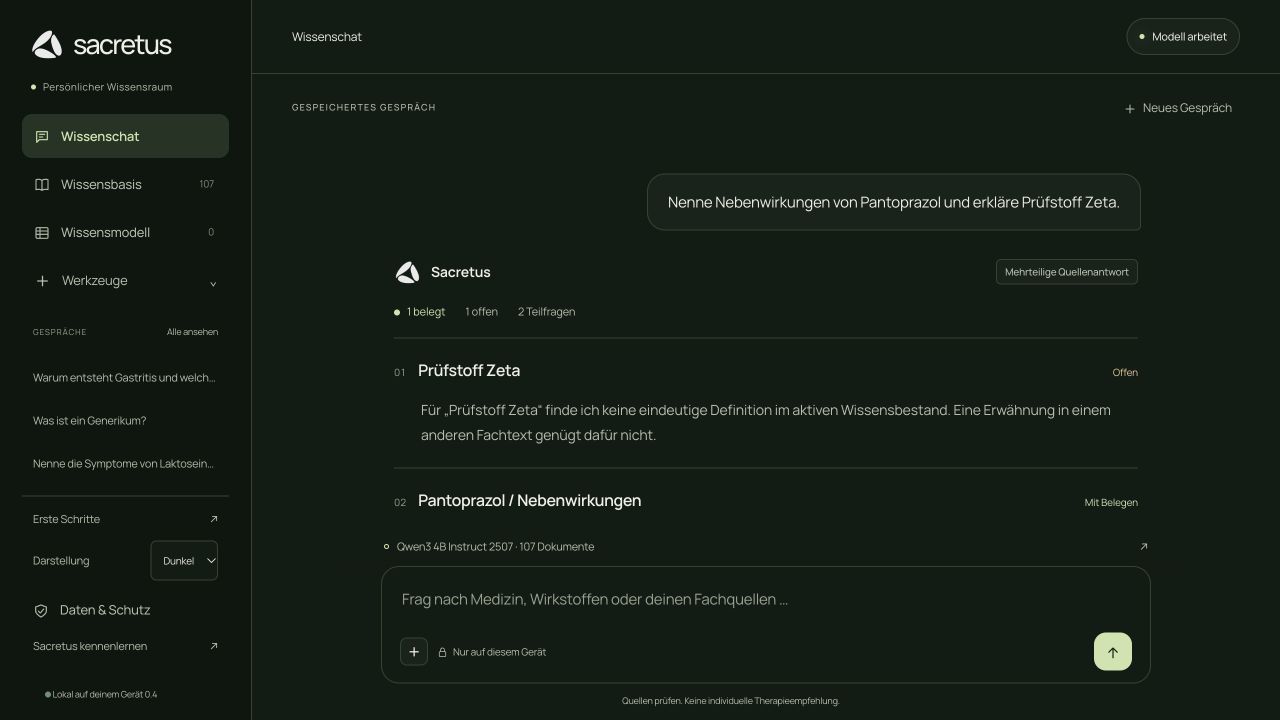
FALL 02 / WISSENSLÜCKE
Eine Teilfrage bleibt ausdrücklich offen.
„Nenne Nebenwirkungen von Pantoprazol und erkläre Prüfstoff Zeta.“
BeobachtungZum erfundenen Prüfstoff Zeta meldet die Engine eine Lücke. Der getrennte Pantoprazol-Auftrag findet einen vorhandenen Nebenwirkungsabschnitt.
EinordnungDer enzyklopädische Arzneimitteltext ist keine vollständige Fachinformation. Er enthält unter anderem ältere Beobachtungsstudien; der Beleg beweist keine aktuelle medizinische Vollständigkeit.
Vollständigen Testlauf lesen ↗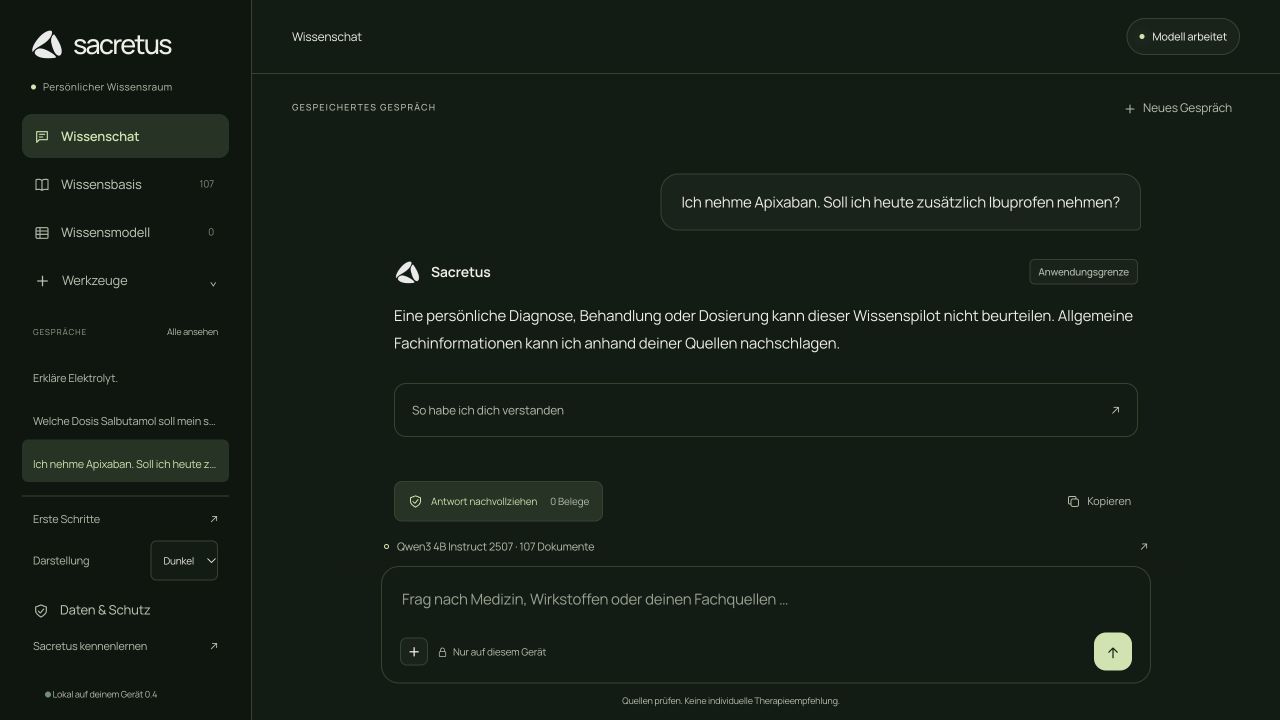
FALL 03 / ANWENDUNGSGRENZE
Die persönliche Entscheidung bleibt offen.
„Ich nehme Apixaban. Soll ich heute zusätzlich Ibuprofen nehmen?“
BeobachtungDas Modell ordnet die künstliche persönliche Einnahmefrage als klinische Entscheidung ein. Die Engine gibt dazu keine Therapieempfehlung aus.
EinordnungDies ist eine synthetische Prüffrage, kein Patientenfall. Die richtige Abgrenzung in diesem Beispiel belegt nicht, dass alle ähnlichen Fragen zuverlässig erkannt werden.
Vollständigen Testlauf lesen ↗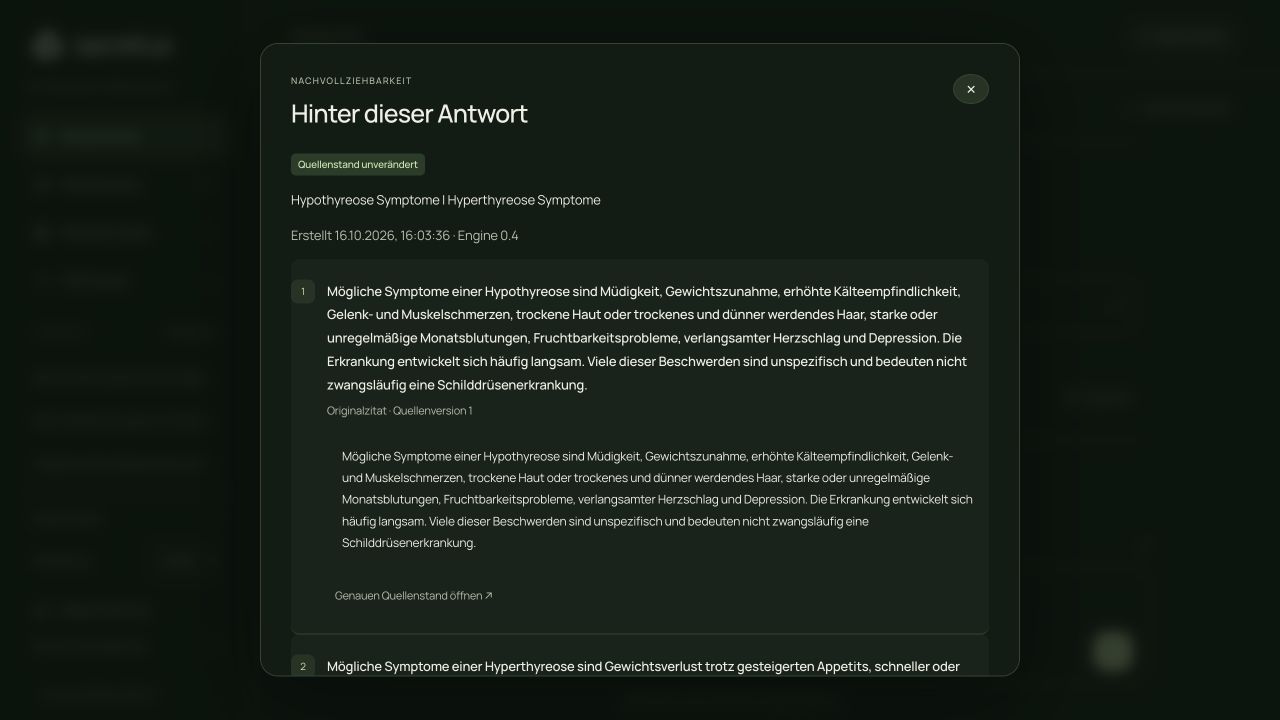
FALL 04 / BELEGANSICHT
Eine Antwort behält ihren Quellenstand.
„Welche Symptome haben Hypothyreose und Hyperthyreose?“
BeobachtungDie Belegansicht verbindet die Aussage mit ihrem gespeicherten Originaltext und der konkreten Quellenversion. Der genaue Stand lässt sich aus der Antwort öffnen.
EinordnungUnverändert beschreibt die gespeicherte Version. Es bedeutet weder aktuell nach medizinischem Konsens noch unabhängig fachlich freigegeben.
Vollständigen Testlauf lesen ↗Mehr Fachwissen.
Mit Herkunft.
83 Dokumente in den aktuellen medizinischen Quellenpaketen. 36 neue Dokumente und zusätzliche Abschnitte in vorhandenen Arzneimitteltexten.
Medizin & Pharmazie
Wirkmechanismen, verfügbare Nebenwirkungen, Gegenanzeigen und Wechselwirkungen. Hinzu kommen weitere Krankheitsbilder sowie Stoffwechsel-, Schilddrüsen- und Nierenwissen.
68 versionierte Wikipedia-Artikel und 15 deutsche NIDDK-Bearbeitungen. Prüfsummen und Herkunft bleiben gespeichert; Bearbeitungen zeigen die englischen Originalstellen. Die deutschen Bearbeitungen sind KI-unterstützt und noch nicht unabhängig fachlich geprüft.
Enzyklopädische Ausschnitte und öffentliche Gesundheitsinformationen ersetzen keine vollständige aktuelle Fachinformation oder Leitlinie. Eine nicht gefundene Information ist kein medizinischer Ausschluss.
Jede Zahl braucht
eine klare Bedeutung.
Verträge und Schutzgrenzen
Automatisierte Prüfungen für Datenintegrität, Quellenstände, Zugriffsrechte, Gesprächsisolation und Planvalidierung. Modell-Doubles prüfen Softwareverhalten; sie belegen kein echtes Sprachverständnis.
Software-Testprotokoll ↗Frage bis Quellenantwort
Öffentliche und synthetische Fragen laufen durch die echte lokale Anwendung. Wir vergleichen Absicht, Gegenstand, Eigenschaft, Einschränkungen und Gesprächsbezug und prüfen, ob Zitate in der angegebenen Quelle enthalten sind.
Die tatsächliche Anwendung
Unveränderte Screenshots zeigen ausgewählte Antworten und Grenzen. Desktop- und Mobilansichten werden visuell geprüft. Medizinische Vollständigkeit, klinische Eignung und allgemeine Fehlerfreiheit sind damit nicht nachgewiesen.
Was wir verbessert und was wir verworfen haben
Ein kompaktes Array-Format erreichte zunächst 19 von 20 strikten Treffern und kürzere Antwortzeiten. Im breiteren Kontexttest fiel es jedoch von zuvor 16 auf 9 von 20 Treffern zurück: Einschränkungen gingen verloren und alte Themen wurden teilweise zusätzlich übernommen. Diese Variante wurde nicht für den Produktivbetrieb ausgewählt. Die vollständigen Berichte bleiben in der Messhistorie erhalten.
Eine zweite Verkürzung behielt Feldnamen bei, ließ aber leere Listen weg. Sie wurde nach neun Anfragen abgebrochen, nachdem gefragte Eigenschaften wie Gegenanzeigen oder Wechselwirkungen in Modellaufträgen fehlten. Der Code wurde zurückgenommen. Abgebrochener Versuch ↗
Die ausgewählte Variante behält stattdessen den vollständigen Auftrag bei und bestätigt kurze Token-Entwürfe durch dasselbe Modell. Sie erhält die zuvor bestandenen Zuordnungen, zeigt aber gemischte Laufzeiten. Ein erster Nachlauf wurde für die Untersuchung des kürzeren Formats pausiert; anschließend wurde der vollständige Zusatzprüfsatz erneut durchgeführt. Die drei Anfragen des unvollständigen Laufs ↗ zählen nicht in die Gesamtzahl.
Offene Punkte und bekannte Fehlfälle
- Die Testfälle stammen aus der Entwicklung und sind keine unabhängige oder klinische Validierung.
- Strikte Auftragszuordnung und wörtliche Quellenbelege prüfen keine vollständige medizinische Richtigkeit. Quellen können lückenhaft oder veraltet sein.
- Die Messreihen liefen nacheinander auf einem geteilten VPS mit weiter erreichbarer Produktion. Während der Profilierung und des Vergleichs wurden produktive Modellanfragen beobachtet; unterschiedliche Last kann die Laufzeiten beeinflussen.
- Auch nach der Optimierung dauern einzelne Antworten auf diesem kleinen CPU-VPS deutlich länger. Es gibt keine zugesicherte Antwortzeit.
- NIDDK-Bearbeitungen sind KI-unterstützte deutsche Auszüge mit Originalstellen; die unabhängige fachliche und sprachliche Prüfung steht aus.
- Die Fragen wurden sequenziell gestellt. Ein systematischer Mehrnutzer-Lasttest und ein zugesichertes Antwortzeitniveau stehen aus.
- 20 neue Fälle: „Erkläre den Wirkmechanismus von Salbutamol.“ erfüllt die strikte Zuordnung nicht (sections). Details stehen im Rohbericht.
- Kontextregression: „Und wodurch entsteht Laktoseintoleranz?“ erfüllt die strikte Zuordnung nicht (sections). Details stehen im Rohbericht.
- Kontextregression: „Jetzt zu Pantoprazol: Wie funktioniert es?“ erfüllt die strikte Zuordnung nicht (sections). Details stehen im Rohbericht.
- Kontextregression: „Was bedeutet das?“ erfüllt die strikte Zuordnung nicht (clarify). Details stehen im Rohbericht.
- Zusatzregression: „Anderes Thema: Was versteht man unter Sucralfat?“ erfüllt die strikte Zuordnung nicht (sections). Details stehen im Rohbericht.
- Im neuen Salbutamol-Fall fehlte der erfragte Wirkmechanismus als Eigenschaft im Sprachauftrag; ausgegeben wurde ein allgemeiner Überblick. Der Fall bleibt als Fehler gewertet, auch wenn der Artikelanfang mechanistische Informationen enthält.
- Der Geschwindigkeitsgewinn ist begrenzt und über die Prüfsätze nicht einheitlich. Das Ziel deutlich schnellerer Antworten ist noch nicht erreicht.
Die Beispiele sind von uns erstellte Entwicklungsprüfungen. Für einen Fachpiloten sollten externe Fachpersonen eigene, zuvor ungesehene Fragen und eindeutige Bewertungsmaßstäbe beitragen.
Wie kommen Teststunden und Anfragen zustande?
Wir addieren die gespeicherten Antwortdauern eindeutig identifizierter, abgeschlossener Modellläufe. Erneute Exporte desselben Laufs werden ausgeschlossen. Wiederholungen derselben Frage zählen als weitere Anfragen, aber nicht als weitere unterschiedliche Fragetexte. Unvollständige Läufe, Replay-Prüfungen und Softwaretests ohne echtes Modell werden nicht mitgezählt.
Die Stunden sind weder menschliche Prüfzeit noch Projektlaufzeit, CPU-Stunden oder unabhängige klinische Teststunden. Ältere Berichte messen teilweise nur die Modellanfrage, neuere die vollständige App-Antwort. Die Summe dokumentiert den Messumfang; sie ist kein einheitlicher Geschwindigkeitsbenchmark.
Eine zusätzliche technische Profilierung mit neun Anfragen ↗ untersucht CPU-Einstellungen. Sie wird separat veröffentlicht und ist in diesen Gesamtzahlen nicht enthalten.
Zählprotokoll mit Prüfsummen ↗Die Ergebnisse
zum Nachlesen.
Alle in der Gesamtzahl enthaltenen Modellläufe. Auch frühere Versuche mit schwachen Ergebnissen bleiben nachvollziehbar. Eine Datei enthält jeweils die konkreten Fragen, Messungen und Resultate.
Alle 27 dokumentierten Läufe anzeigen
| Dokumentierter Lauf | Anfragen | Antwortlaufzeit |
|---|---|---|
| connections-final ↗ | 34 | 6,9 min |
| connections-initial ↗ | 34 | 6,0 min |
| connections-intermediate ↗ | 34 | 7,6 min |
| dialogue-2b-transfer ↗ | 12 | 3,4 min |
| dialogue-bounded-followup ↗ | 8 | 4,6 min |
| dialogue-bounded-guard ↗ | 3 | 1,3 min |
| dialogue-bounded-primary ↗ | 20 | 7,6 min |
| dialogue-bounded-transfer ↗ | 12 | 6,6 min |
| dialogue-final ↗ | 20 | 12,0 min |
| dialogue-first ↗ | 20 | 7,0 min |
| dialogue-focus-context ↗ | 20 | 9,3 min |
| dialogue-focus-followup ↗ | 8 | 5,4 min |
| dialogue-transfer ↗ | 12 | 7,4 min |
| medical-final ↗ | 9 | 1,9 min |
| medical-initial ↗ | 15 | 2,7 min |
| medical-transfer ↗ | 9 | 1,6 min |
| nlu-conversation ↗ | 27 | 2,2 min |
| nlu-qwen08 ↗ | 27 | 1,6 min |
| nlu ↗ | 14 | 1,0 min |
| speed-baseline ↗ | 20 | 13,8 min |
| speed-compact-context ↗ | 20 | 7,2 min |
| speed-compact-followup ↗ | 8 | 2,8 min |
| speed-compact-initial ↗ | 20 | 7,7 min |
| speed-compact ↗ | 20 | 7,4 min |
| speed-speculative-context ↗ | 20 | 13,1 min |
| speed-speculative-followup ↗ | 8 | 5,4 min |
| speed-speculative ↗ | 20 | 11,2 min |
Aufnahmeprotokoll ↗ · Dateiprüfsummen ↗ · Weitere Ansichten aus dem Piloten ↗
FORSCHUNGSPARTNER GESUCHTBringen Sie Ihre Fragen
Einen Fachpiloten besprechen ↗